
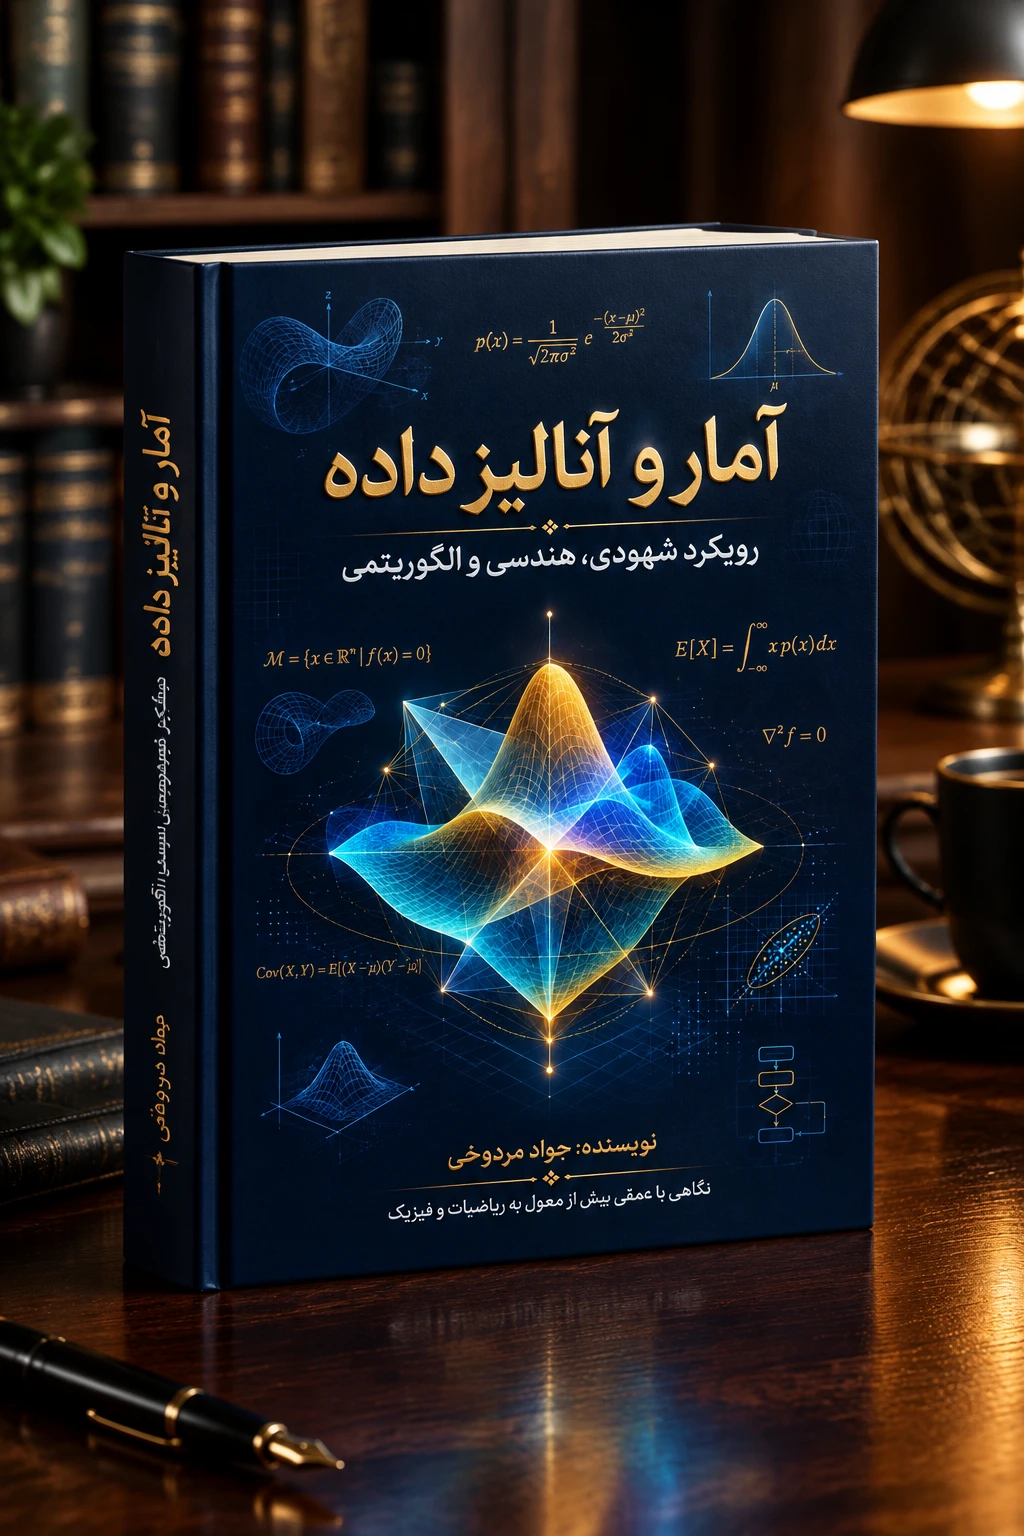

کتاب آمار و آنالیز داده- pdf
رویکرد شهودی، هندسی و الگوریتمی
ریاضیات زبان جهان است و آمار، هنر استخراج معنا از دل آشوب. اما سالهاست که در نظام دانشگاهی و منابع رایج، آمار به مجموعهای از دستورالعملهای خشک، جداول محاسباتی و فرمولهای انتزاعی تقلیل یافته است؛ گویی هدف صرفاً رسیدن به یک عدد (مانند p-value) بدون لمس واقعیت هندسی و فیزیکی آن است.
این کتاب با یک پرسش بنیادین متولد شده است:
پشت فرمولهای آمار، در فضای برداری و فیزیک دادهها واقعاً چه رخ میدهد؟
1. در این کتاب:
- متغیرهای تصادفی، نقاط یا توابعی مجرد نیستند.
- واریانس و همبستگی، مفاهیمی تحلیلی-هندسیاند؛ واریانس مجذور فاصله است و همبستگی زاویه میان دو بردار در فضای ضرب داخلی.
- استنتاج بیزی، فرمول ساده شرطی نیست؛ بازنمایی هندسی سازوکار ذهن در مواجهه با عدم قطعیت و ترجمان ترمودینامیک اطلاعات است.
کتاب «آمار و آنالیز داده» در۶ بخش منسجم و ۲۱ فصلدقیق طراحی شده تا مخاطب را از سطح آکسیومهای نظریه اندازه به قله مدلسازیهای مدرن هوش مصنوعی و یادگیری ماشین برساند.
۲. ساختار و نقشه راه کتاب (۲۱ فصل در ۶ بخش)
چینش فصول کتاب بر اساس یک سیر تکاملی از مبانی محض تا سنتز پیشرفته تدوین شده است:
بخش ۱: پایهگذاری (از احتمال به آمار)
- فصل ۱: فرآیند معکوس (تفاوت مسیر «مدل به داده» در احتمال و «داده به مدل» در آمار)
- فصل ۲: تفاوت پارامتر جامعه (مقدار حقیقی و پنهان) و آماره نمونه (ابزار تقریب)
- فصل ۳: تصحیح جامعه متناهی (FPC) و برآورد بدون سوگیری (Unbiased Estimation)
بخش ۲: استنباط و تصمیمگیری (رویکرد فرکانتیستی)
- فصل ۴: قضیه حد مرکزی (CLT) و توزیع نمونهای (قلب تپنده استنتاج آماری)
- فصل ۵: فاصله اطمینان و مقدمات آزمون فرض (ورود به تصمیمگیری در شرایط عدم قطعیت)
- فصل ۶: آزمونهای یکدامنه و دودامنه (چارچوب نیومن-پیرسون، خطاهای نوع اول و دوم)
- فصل ۷: مطالعه موردی واکسن سالک (۱۹۵۴) و اهمیت گروه کنترل در کارآزماییهای بالینی
- فصل ۸: اخلاق آماری، P-hacking، پدیده HARKing و چالش آزمونهای چندگانه (بسط تفصیلی مباحث فصول قبل)
بخش ۳: تخمین پارامتر (فهم عمیق مدلها)
- فصل ۹: برازش توزیع (کشف الگوی پنهان در دادهها، معمای بایاس و واریانس)
- فصل ۱۰: روش گشتاورها (Method of Moments)
- فصل ۱۱: شبیهسازی مونتکارلو و تکنیک بوتاسترپ (رویکردهای محاسباتی در تخمین)
- فصل ۱۲: برآورد بیشینهنمایی (MLE) مقدماتی (شهود پایهای با توزیع پواسون و شمارشگر گایگر)
- فصل ۱۳: MLE عمیق (مفاهیم پیشرفته: اطلاعات فیشر، نامساوی کرامر-رائو و کارایی مجانبی)
بخش ۴: ابزارهای پیشرفته و انتخاب آزمون
- فصل ۱۴: توزیعهای مشتقشده از نرمال (معرفی کای-دو χ2\chi^2χ2 و تی استیودنت ttt)
- فصل ۱۵: آزمون نیکویی برازش (کاربرد کای-دو و شگفتیهای قانون بنفورد)
- فصل ۱۶: فلوچارت عملی انتخاب آزمون (نقشه راه کاربردی برای دانشجویان جهت انتخاب ابزار درست)
بخش ۵: آمار بیزی (تغییر پارادایم)
- فصل ۱۷: مقدمه استنتاج بیزی (فلسفه احتمال ذهنی، توزیع پیشین، تابع درستنمایی و توزیع پسین)
- فصل ۱۸: توزیعهای مزدوج (Conjugate Priors) و محاسبات تحلیلی دقیق
- فصل ۱۹: خانواده نمایی (Exponential Family) و ارتباط آن با استنتاج بیزی
- فصل ۲۰: شبیهسازی MCMC در پایتون و معرفی بوتاسترپ بیزی (گذار از تحلیلی به محاسباتی)
بخش ۶: سنتز نهایی
- فصل ۲۱: رگرسیون خطی از سه دیدگاه (بررسی یکتای یک مدل از لنزهای MLE، MAP و استنتاج کامل بیزی)
3. این کتاب برای چه کسانی مرجع است؟
- متخصصان هوش مصنوعی، یادگیری ماشین و علم داده:کسانی که نمیخواهند الگوریتمها و توابع زیان را مانند یک «جعبه سیاه» اجرا کنند، بلکه به دنبال درک ریاضی رفتار مدل در فضاهای با ابعاد بالا هستند.
- دانشجویان و پژوهشگران تحصیلات تکمیلی:دانشجویان رشتههای ریاضی، آمار، فیزیک نظری و مهندسی که به متنی یکپارچه، عمیق و فارغ از سطحینگری نیاز دارند.
- اساتید و مدرسان دانشگاهی:مدرسانی که به دنبال زبانی نو، شهودی و ساختارمند برای انتقال مفاهیم انتزاعی به نسل جدید پژوهشگران هستند.
4. مشخصات اثر و دریافت کتاب
- عنوان: آمار و آنالیز داده
- مؤلف: جواد مردوخی
- قالب ارائه: نسخه دیجیتال با فرمت PDF استاندارد
- تعداد صفحات: 430 صفحه
5.دانلود نمونه صفحات کتاب: sample-AandA_Preview.pdf